Правило в robots.txt може виглядати зрозумілим для людини й водночас нічого не означати для пошукового робота. Google нагадала, як працюють директиви файлу, де можна використовувати кирилицю та емодзі й чому обмеження сканування потрібно відрізняти від керування використанням контенту для ШІ.
Ці питання розібрали Гарі Ілліш і Черрі Проммавін у другому випуску The Non-Canonical Cabinet — «What can you actually put in a robots.txt?». Google Search Central представила його в офіційному повідомленні про відео.
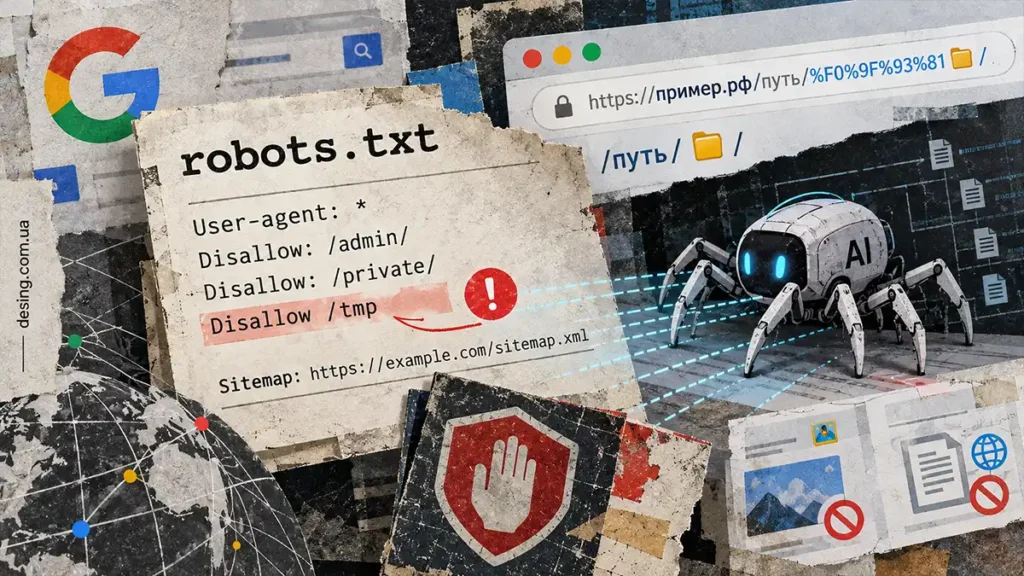
Базове правило просте: robots.txt — текстовий файл у кодуванні UTF-8 із визначеним синтаксисом. Google підтримує поля User-agent, Allow, Disallow та Sitemap. Останнє є додатковим записом для карти сайту: підтримку розширень у різних краулерів варто перевіряти окремо.
Якщо написати звичайною мовою «не сканувати секретну сторінку», Googlebot не перетворить побажання на правило. Нерозпізнаний рядок буде проігноровано. Для обмеження потрібна коректна директива з відповідним шляхом.
Коментарі починаються із символу #. У них можна залишати пояснення й навіть ASCII-малюнки, як пожартували автори випуску. Але декоративний текст не повинен заважати читати та перевіряти значущі правила.
Для ідентифікатора робота й шляху URL діють різні обмеження. За RFC 9309, product token у полі User-agent складається з латинських літер, дефісів і символів підкреслення. Окремо передбачено значення * для всіх краулерів. Емодзі чи кириличне ім’я робота цьому синтаксису не відповідають.
Натомість у шляхах можуть бути кирилиця, ієрогліфи, літери з діакритичними знаками та емодзі. У документації Google прямо зазначено: її парсер підтримує як звичайні UTF-8-символи, так і їхній процентно закодований запис.
Наприклад, шлях /стаття/ можна записати як /%D1%81%D1%82%D0%B0%D1%82%D1%82%D1%8F/. Для Google ці форми зіставляються еквівалентно.
Рекомендація використовувати percent-encoding стосується передусім сумісності. Інші або старіші краулери можуть обробляти символи інакше. Тому варто перевіряти правило на фактичному URL і враховувати реалізацію конкретного бота. Google не оголошувала заборони на кирилицю в robots.txt.
Окрема тема — AI-краулери. Стандарт robots.txt визначає побажання щодо доступу для сканування. Він не описує універсальну політику того, що система може робити з даними після їх отримання.
Disallow обмежує сканування відповідного шляху для бота, якого стосується правило. Довільний рядок на кшталт «заборонено використовувати для навчання ШІ» стандартний парсер обробляти не зобов’язаний. Для конкретного краулера потрібно брати його документований токен і підтримувані ним правила.
Водночас компанії можуть запроваджувати власні механізми керування використанням матеріалів. Наприклад, Google-Extended — спеціальний керівний токен. Він не має окремого HTTP User-Agent: Google використовує вже наявні краулери, а токен визначає певні способи використання зібраного контенту.
За документацією Google, цей механізм стосується навчання майбутніх моделей Gemini та окремих сценаріїв grounding — підкріплення відповідей інформацією з джерел. Налаштування Google-Extended не впливає на включення сайту до Google Search і не є сигналом ранжування.
Також robots.txt не закриває доступ до конфіденційних файлів на сервері. Добросовісні краулери враховують його правила, але сторонній клієнт може їх проігнорувати. Для приватної інформації потрібне реальне обмеження доступу.
Заборона сканування не гарантує й видалення URL із пошуку. Google може дізнатися про адресу з посилань та інших джерел і показати її без завантаження вмісту. Якщо завдання — керувати індексацією, його потрібно розглядати окремо від правил обходу.
Після редагування я б перевірив синтаксис, відповідність шляхів і фактичну доступність сторінок для потрібного краулера. Останнє залежить також від CDN та систем захисту: ми вже розбирали, як CAPTCHA може перекрити Googlebot доступ до справжнього вмісту, хоча сайт нормально відкривається у браузері власника.
Новий випуск не змінює стандарт robots.txt. Він нагадує розділяти три завдання: які сторінки дозволено сканувати, що має потрапляти в індекс і які правила використання контенту підтримує конкретний AI-сервіс.